不会用都是浮云!热门 Agent 到底该放哪干活?自媒体与数据抓取全自动实操
买了一堆订阅却每天手动搬砖?Grok 当云端母机、Gemini 抓笔杆、Muse 跑海外分发、Dots 跑代码。讲透每个工具该呆的工位,把自媒体运营与数据抓取做成 24 小时无人值守产线。
现在市面上最不缺的,就是各种被吹上天的新 Agent:Grok Bot、Muse、Claude Code、Gemini Argon、gpt dots、Codex……
很多人兴冲冲买了一堆订阅,终端装了一堆环境,初衷都是想“合上电脑让 AI 把活干了”。但折腾一圈下来,绝大多数人都陷入了深深的疲惫:
MacBook 不敢合盖,合盖就断网杀进程;让 Grok 写篇中文长文,交上来一股机翻塑料味;把几个 Bot 拉进一个群,讨论几百条消息却没人交出最终文档;为了盯账号数据,每天依然得定闹钟手动刷新各大后台。你不仅没享受到 AI 的红利,反而成了 24 小时待命的“赛博保姆”。
工具不会用,全都是浮云。
你觉得 AI 鸡肋,根子在工位放错了。每个当下最火的 Agent 都有极其致命的短板,也都有别人替代不了的绝活。这篇文章不聊虚的,直击自媒体运营与数据抓取的真实痛点,教你把手头的 Bot 放到正确的工位上,串成一条不用你操心的云端产线。
工位拆解:当下最火的 Agent 该放在哪?
很多人最大的误区,就是试图找一个“全能 Bot”包办所有事。现实中根本不存在这种全能选手,必须按各自的长板精准定岗:
第一个,Grok Bot:天命工位是“24 小时云端母机与调度总监”。
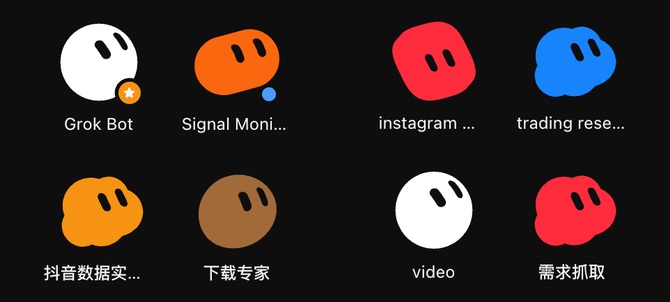
它最值钱的地方,是云端那台永不断电的独立 Linux 虚拟机,自带稳定网络、终端环境和内置云浏览器。以前本地跑脚本,笔记本合盖就断网;而 Grok Bot 扔在云端能 24 小时值守,是天生的总控调度台。但它有致命硬伤:中文写作生硬,充满翻译腔,绝对不要直接让它去写长文正文。
第二个,Gemini (Argon):天命工位是“顶级笔杆子与分析大脑”。
Gemini 的长文逻辑周密、词汇细腻,尤其擅长长文本消化与多维度内容润色,是目前最能写出深度思考的模型之一。但它没有自带一个能 24 小时挂机跑定时脚本的常驻云端容器。
第三个,Muse:天命工位是“海外社媒分发手与防风控操盘手”。
针对 Instagram、X 等平台,Muse 自带拟人化浏览器操作、防风控机制和定时发帖排程。海外自媒体的日常排期交给它最省心,但它做不了全局通用调度。
第四个,gpt dots / Claude Code / Codex:天命工位是“代码与复杂环境手艺人”。
代码重构、格式转换、本地文件清洗,交给这类专精代码的工具稳准狠。但它们是纯粹的重活执行端,需要极为明确的目标,绝不能扔进开放性讨论里让它们自由发挥。
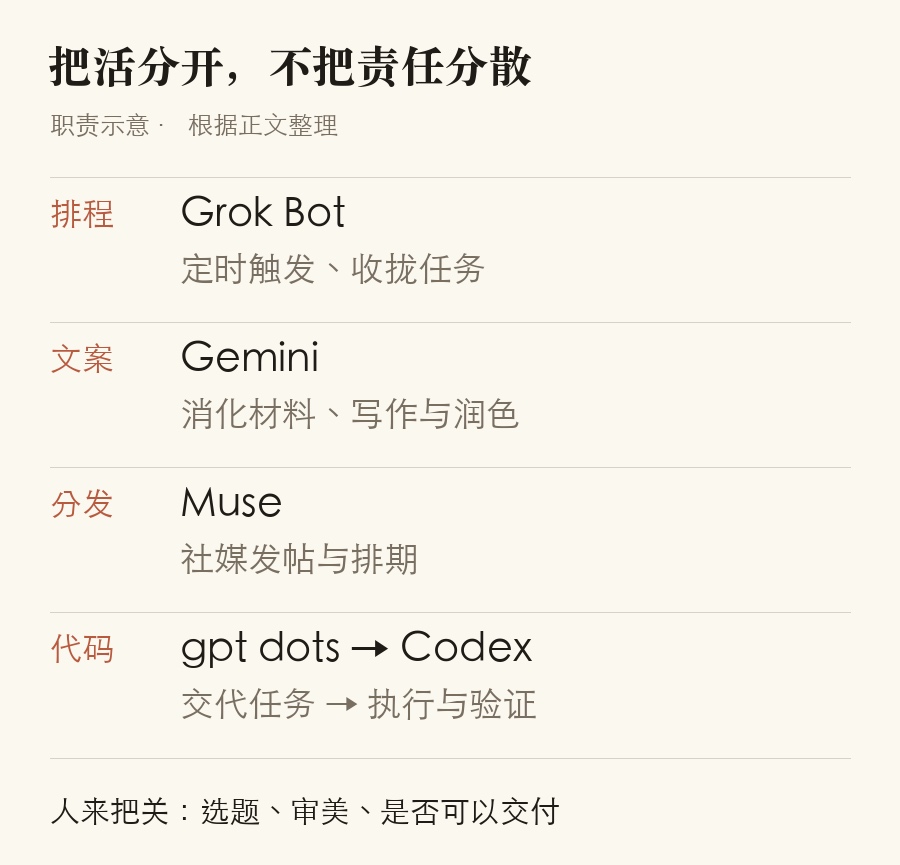
搞清楚工位划分,你就明白怎么搭积木了:Grok 当云端底座负责盯排期,Gemini 负责出文案,Muse 负责发社媒,Dots 负责跑代码。各归其位,效率才能跑起来。
先把这 2 个机械活交出去,每天少刷两小时后台
做自媒体和运营,最耗精力的往往是日常满世界搜线索、频繁刷新后台这些机械搬砖。这两个动作,必须第一批交出去:
动作一:全网抱怨与痛点抓取(需求端)。
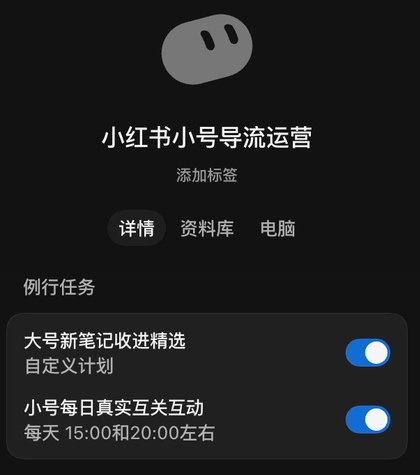
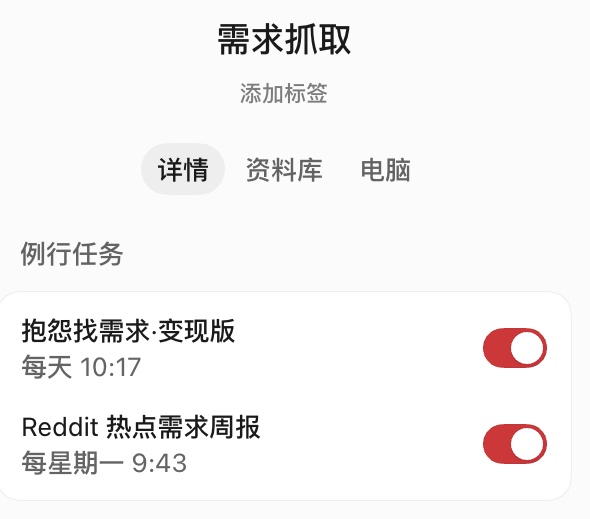
做内容或做变现,最怕每天靠记忆打开各个社区大海捞针。我在 Bot 里挂了两项固定排程:每天 10:17 自动跑“抱怨找需求·变现版”,每周一早晨跑“Reddit 热点需求周报”。
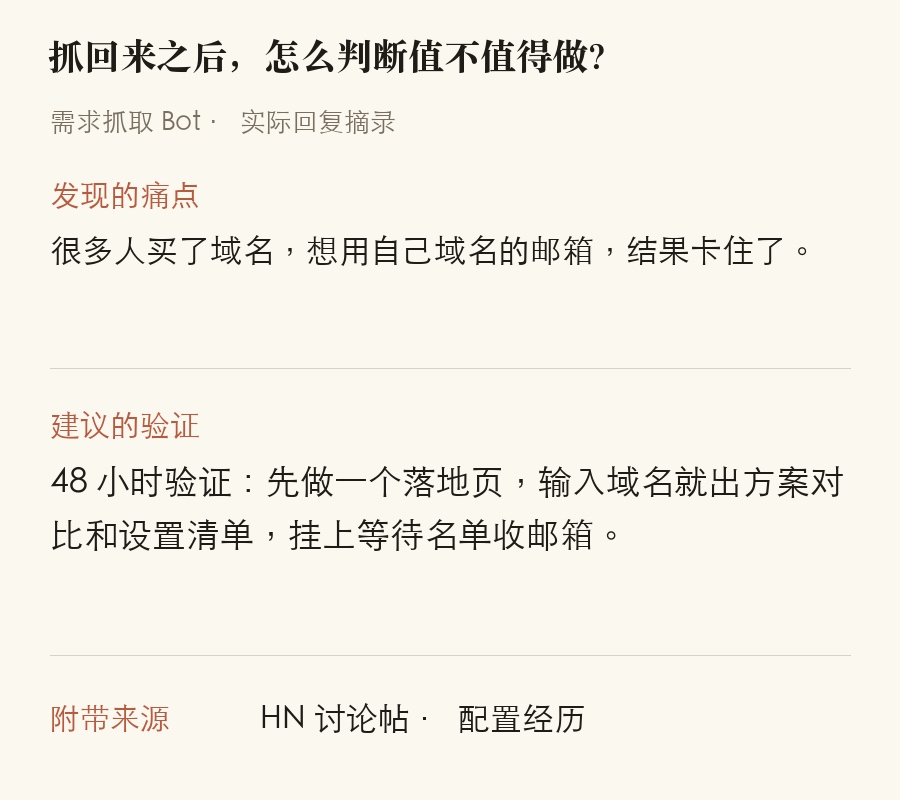
把“全网去找、去扫、去归纳”的体力活彻底扔掉。它每天准时把各大平台的用户吐槽、未被满足的痛点整理成清单推送到面前。你只需要在喝咖啡时花 3 分钟扫一眼,判断哪个痛点有人愿意掏钱买单。机器负责把麦子割回来,你负责挑出真正值钱的颗粒。
动作二:账号数据与品牌舆情实时盯盘(数据端)。
做运营最容易陷入的焦虑,就是每隔半小时就想去刷一下后台:新视频播放量爆没爆?评论区有没有恶评?对标账号今天更了什么?这种琐事会把注意力切得稀碎。
我配置了一个“抖音数据实时抓取”Bot:早晚 10:00 和 23:00 各扒一轮关注账号表现,早中晚分批扫品牌舆情,下午盯着蝉妈妈每日选题。
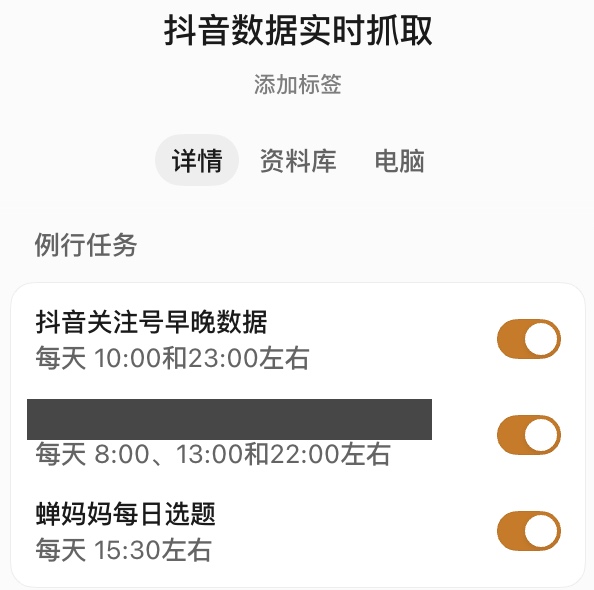
让 Bot 定时把盘面数据抓好送到眼皮底下,数据异常自动标红。你每天只需要看定点简报做决策,彻底从无意义的页面刷新中解脱出来。
云端母机实操:一句话把 Gemini 与 Muse 接入 24 小时产线
既然 Grok 擅长云端挂机但写不好,Gemini 文笔极佳但缺云端容器,Muse 擅长发帖但缺总控,那怎么把它们拼成一套全自动流水线?
操作其实简单得超乎想象,只要掌握核心的串联技巧:
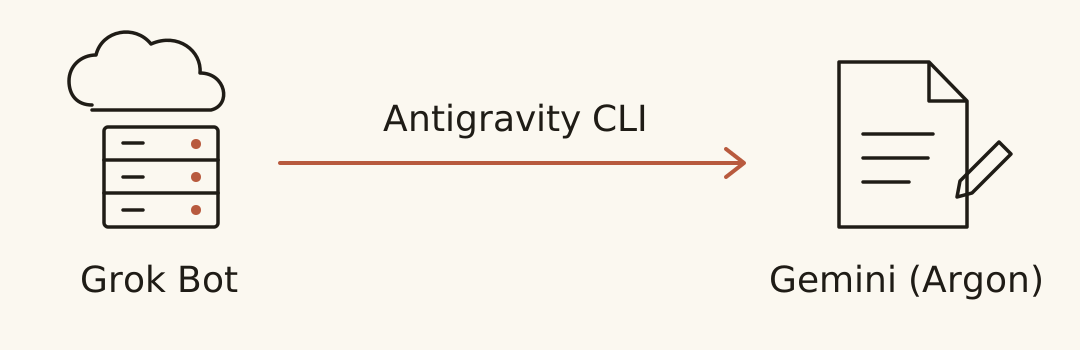
第一步:用 Antigravity CLI 把 Gemini 接入 Grok 终端(解决文笔与深度思考)。
因为 Grok Bot 在云端就是一台完整的 Linux 虚拟机,支持在终端安装并运行命令行工具。直接在 Grok Bot 提示词窗口输入这句指令:
“请新建一个 Gemini Bot,在你的终端通过 Antigravity cli 方式接入 Gemini,默认使用 Argon 模型,我授权你用我的谷歌账号完成登录。”
这里包含一个价值巨大的关键避坑点:一定要提前在 Grok Bot 自带的云浏览器里,登录好你的美区谷歌账号。当终端跑起 Antigravity CLI 弹出 OAuth 授权网页时,直接在内置云浏览器里点一下允许,几秒钟就能完成鉴权绑定。
绑定成功后,只要产线遇到长文撰写、选题深化、文案去油等脑力活,Grok 母机自动把请求抛给底层的 Gemini Argon 处理。用顶级的文笔,直接绕开 Grok 原生的写作短板。
第二步:把 Muse 排程嵌入 Grok 母机(解决海外社媒全托管)。
海外自媒体运营(如 Instagram 或 X),直接让 Grok 母机调度 Muse。我挂了每天 18:37 自动发帖,外加早晚两次自我学习。
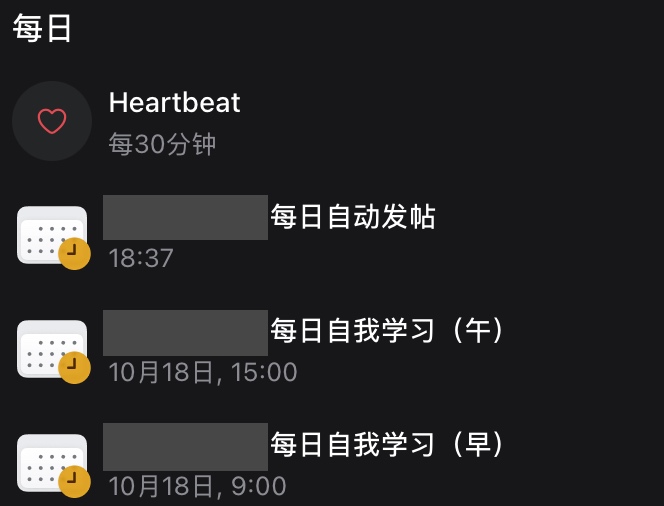
Grok 母机在云端守着定时触发时钟,具体的浏览器渲染、防风控和点击发布交给 Muse 这个海外发帖专家。本地不用开机,海外社媒每日准时更新。
第三步:重活与代码,按需调 Claude Code 或 Codex。
遇到数据清洗脚本报错、页面接口调整或复杂代码重构,云端母机直接将任务分派给 Claude Code 或 Codex,执行端跑通并验证产物后回传母机收口。
以前你在本地 MacBook 上想尽办法挂机、整天担心发热休眠的自动化流程,在云端母机上就自然而然地 24 小时跑通了。
避坑指南:为什么你的多 Agent 总是变成赛博灾难?
很多人刚接触多 Agent 时,脑子里都有个美好的幻想:我建几个不同的 Bot,一个负责找选题,一个负责写初稿,一个负责审稿改错,这不就能翘着二郎腿等成果了吗?
但真去实操过的人,十个有九个被折腾得想砸电脑——原本是为了偷懒,结果比自己动手还要累十倍。
核心原因,就是踩了两个最容易让人抓狂的大坑:
大坑一:拉个“AI 讨论群”让它们自己聊,聊得再火热也没人交作业。
我最早测试多 Agent 时,就在 Grok 里拉过一个群,安排了三个 Bot:一个抓热点,一个写大纲,一个挑刺算成本,让它们在群里自由头脑风暴。
一上午过去,群里的消息提示响个不停,AI 之间互相客套、补充、辩论,聊了几百条,气氛火热得像大厂跨部门开会。
我以为剧本早该写好了,兴冲冲在群里问了一句:
“所以聊完了吗?成稿在哪?把最终文件发给我。”
群里瞬间死一般安静。
找热点的 Bot 回复我,它只负责提灵感,正文该写手写;写手 Bot 又回复我,大纲没得到人工最终批准,它一个字都不敢动。
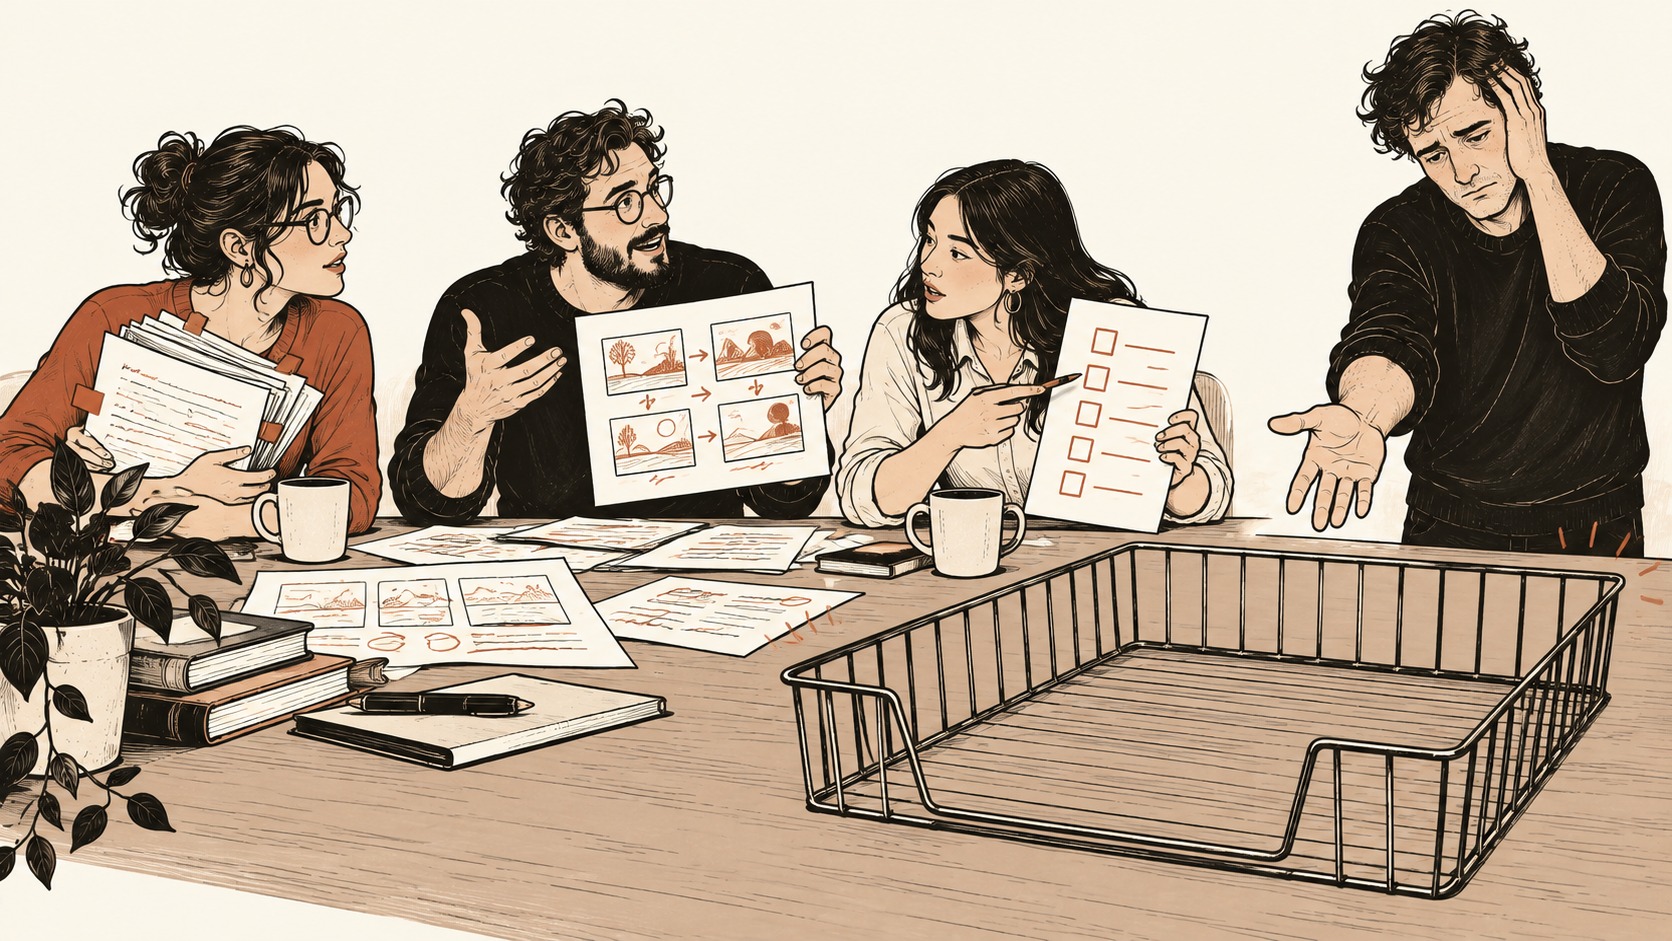
这就是最典型的翻车现场:AI 根本没有主动交付的意识。
只要你让几个 Bot 在一个群里自由商量,它们就会把踢皮球发挥到极致。几百条讨论看似热闹,打开文件夹一看全是空的。最后你不仅没省心,还得亲自坐下来翻聊天记录,一条一条去当它们的保姆兼裁判。
大坑二:光给“禁词清单”,却从不给它真正的骨架。
还有不少朋友用 AI 写内容,总觉得文案假大空、一股机翻塑料味。于是到处找各种“去 AI 味词表”,给模型立一堆规矩:不准用“总而言之”、多用口语、要有人味……
结果往往更崩溃:AI 每次交稿都极其客气地回一句“好的,已严格去除 AI 味并完成自检”,但正文依然干瘪生硬得像说明书。甚至有时候,它还会自作聪明地把提示词当成金句塞进正文:
“因此先问清需求,而不是猜一个答案就动手”
读者是来看真实干货的,不是来看你的模型做思想检讨的。
为什么会这样?因为禁词表只能告诉它“别写什么”,却无法凭空教会它“什么是好的”。
能打动人的好内容,核心永远是真实的经历、具体的细节和明确的态度。这些血肉骨架你不喂给它,光靠在字词上挑刺,它再怎么改也只是换个花样的假把式。
想让自动化真正跑顺,
踩过一圈坑之后我发现,要想让这套产线真正省心,不需要搞复杂的流程图,直接在提示词里立死这三条大白话规矩就行:
第一条:单线派工,必须指定唯一的“交卷人”。
千万别建开放式的多 Bot 讨论群。整个流程必须是串联的:A 找完素材直接给 B,B 写完直接给 C。最后必须指定唯一的总控 Bot(比如你的云端母机 Grok)把最终成品交给你。
指令里直接写死:“除了最终交付的文件,不要汇报过程废话;需要我决策时,直接列出 A/B 两个方案和理由。”只有一个 Bot 负责跟你对齐,踢皮球的问题当场解决。
第二条:只看落地文件,拒绝空头支票。
当你让 Bot 去调外部工具(比如让 gpt dots 调 Codex 写代码、洗数据)时,AI 最擅长打哈哈。它经常秒回一句“已经在为您执行了”,但实际上后台可能因为参数不对直接卡死报错了,它却根本不吭声。
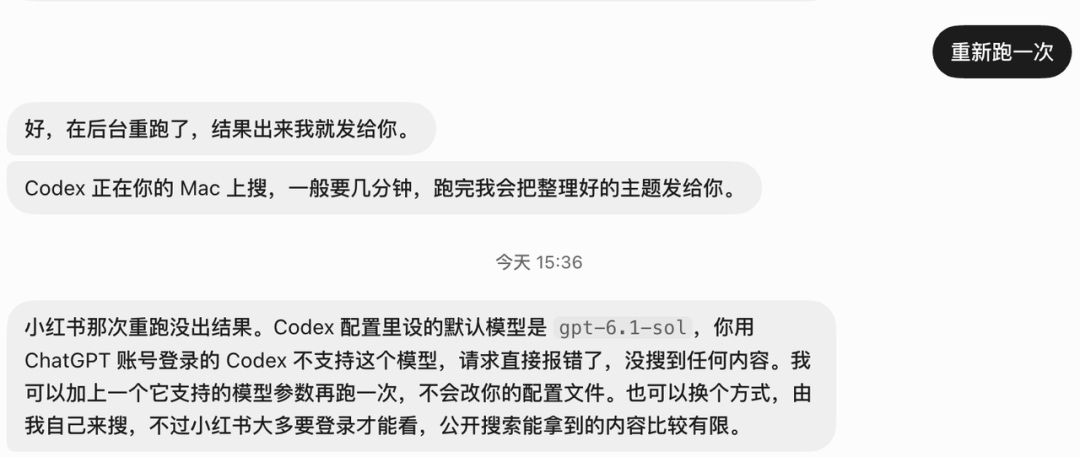
对所有干粗活的 Bot,把要求钉死在指令里:“别光说‘在做了’,改了哪几个文件?跑通测试的结果在哪?生成的文件保存在哪个具体路径?”见不到切切实实生成出来的文件,一律当成没干。
第三条:做完一步锁一步,图和文字绝对不混着改。
这是新手最容易吃的大亏:好不容易把封面的构图和排版调顺眼了,下一轮随口让它“帮我优化一下标题”,结果 Bot 一抽风,顺手把图片提示词全推翻重写了,前面半小时的微调全打了水漂。
记住:改文字就是改文字,改视觉就是改视觉。文字定了,立刻发指令:“文字已定稿,接下来只准排版,不准改动任何正文”;封面定顺眼了,立刻锁死:“图片已定稿,不准重新生成”。做完一步锁死一步,你就永远不会陷入“改了前头坏了后头”的死循环。
说到底,自媒体和数据抓取的自动化,从来不是买个神器就能一键躺平。
你更像是一个工地的总工:不需要亲自去搬砖,但必须清楚每个工人适合干什么。脏活累活和 24 小时值守交给云端母机,文案润色交给笔杆子,海外分发和防风控交给专业工具,写代码找代码专家。
把每个工具放到它该呆的工位上,规矩立清楚,你才能真正放心地合上电脑,把自己的时间踏踏实实买回来。